数学建模社区-数学中国
标题: 助力国赛 | 第4弹 灰色预测 [打印本页]
作者: 杨利霞 时间: 2020-6-7 14:18
标题: 助力国赛 | 第4弹 灰色预测
: P- l: a% H; s7 g F
助力国赛 | 第4弹 灰色预测
% ?% S! V% s' B8 y G* e
0 M7 j# @" J# F9 q) e1 A
! h* r- G3 o- d前言上次介绍了规划问题。规划问题是一类比较重要的问题,在数学建模中出现的比率也比较高,希望各位能多去关注一下。本次将会介绍另一类问题——预测问题。在数学建模中遇到预测问题也是比较常见的事,甚至在有些赛题中还占了主导地位。灰色模型(Gray Model,又称灰色理论)在处理数据预测方面有着很大的优势,也是在数学建模上被广泛使用的一个模型,效果往往很不错,是数模参赛选手必须要掌握的模型之一。
灰色系统,是由国内科学家自主提出来的一个理论,经过快40年的发展,已经有严格的理论基础了,在海内外影响十分的大。其最大的有点就是实用。用灰色模型预测的结果比较稳定,不仅仅适用于大数据量的预测,在数据量较小时(只要数据多于3个即可)预测结果依然较准确。如果各位对灰色模型有着强烈的兴趣,可以去阅读相关方面的书籍,本文只是简单介绍下灰色模型的基本概念和GM(1,1)模型的应用。
- 模型简介
- GM(1,1)操作步骤
- 实际应用; J- N8 q% x3 x& s7 `, n
) q8 Q" b# T: O7 q模型简介灰色系统,是由华中科技大学控制科学与工程系教授,博士生导师邓聚龙于1982年提出的,在短短的三十多年的时间里,得到了飞速的发展,应用已渗透到自然科学和社会经济等许多领域,显示出了强大生命力,具有广阔的发展前景,在海内外影响十分的深远。一些大学还开设了相关研究机构,并且招收研究生和博士生,已成为系统工程和控制领域一个比较热门的研究方向。国内在这方面有着比较深入研究的机构有南航,我想主要还是邓聚龙老先生的学生刘思峰在那里。* j) D* q. q( C0 |+ w4 X7 A$ g! D
灰色系统理论认为,系统的行为现象尽管是朦胧的,不完全透明的,数据是复杂的,但是是有序的,是具有整体功能的。灰色系统的灰就是这种状态,“朦朦胧胧”,“似乎明朗但又不完全明朗”。基于数据是有序的这一点假设,需要我们对数据进行一个预处理,我们把处理后的数据序列成为生成列。进行处理的目的不是寻求它的统计规律和概率分布,而是将其变为有规律的时间序列数据,一句话概括就是——以数找数的规律,建立动态模型。灰色系统一般有两种数据处理的方式,累加和累减,一般采用累加方法。
那么灰色预测就通过鉴别系统因素之间元素发展趋势的相异程度,并对原始数据进行生成处理来寻找系统变动的规律,生成有较强规律性的数据序列,然后建立相应的微分方程,从而来预测事物的未来发展趋势的目的。灰色预测的数据就是通过生成数据的模型所得到的预测值的逆处理结果。灰色预测是以灰色模型为基础的,其中所建立的微分方程模型有很多种比如说GM(2,1),GM(1,1)等,下面主要介绍GM(1,1)。
GM(1,1)操作步骤在诸多的灰色模型中,以灰色系统中单序列一阶线性微分方程模型GM(1,1)模型最为常见,其具体操作步骤如下:
设有原始数据列
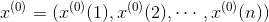
,

为数据个数。
(1)数据预处理原始数据累加以便弱化随机序列的波动性和随机性,得到新数据序列:
! I" R, n1 ^7 ^6 x+ C: t
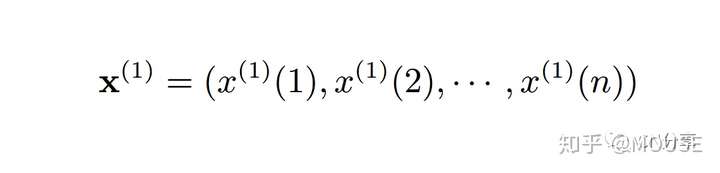
" i$ T6 J, K3 K3 u其中

,
中各数据表示对应前几项数据的累加。
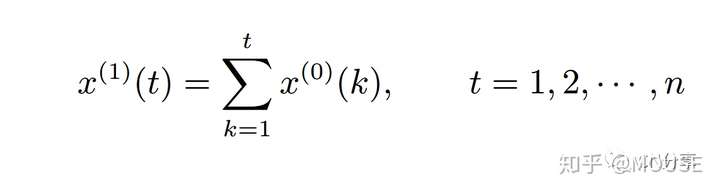 (2)建立微分方程
对
建立的一阶线性微分方程:$ |6 T* G2 u/ L( t* W# k
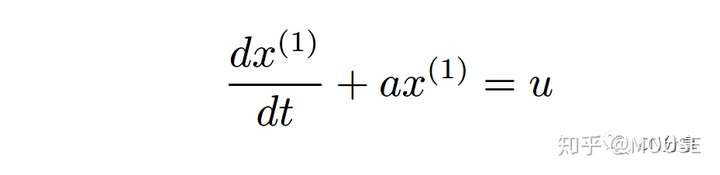 # r5 ?# g8 r$ A6 C+ P9 g9 y! R
其中,

、

为待定系数,分别称为发展系数和灰色作用量;
的有效区间是

;并记
、
构成的矩阵为

。所以只要确定了参数
、
,就可以求出
,进而求出

的未来预测值。
) R1 h& b! f& C' Q(3)确定参数先对累加生成数据做均值生成

与常数项向量

,即 U3 g* G% T8 Z4 }
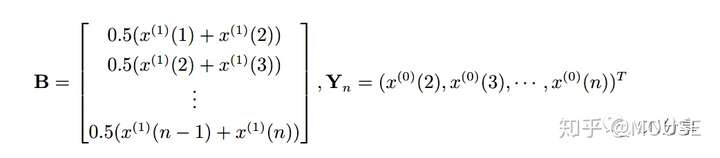
* i1 M1 r; R8 s! r* J9 A' H然后用最小二乘法求解参数

则,
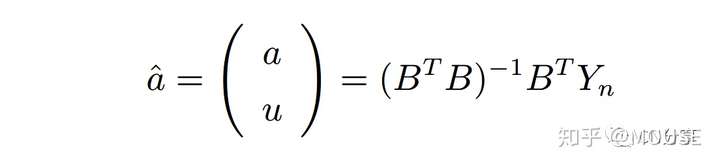
+ Z8 b3 f9 a' H: W# F( k将灰参数
待人
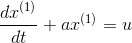
,并对
进行求解,得:
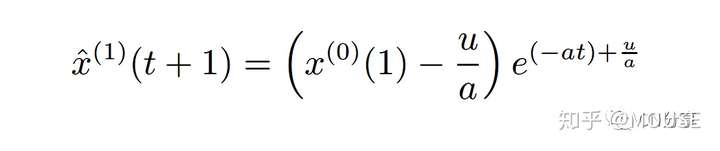
* l4 F0 h/ E5 F7 k, N; _, V+ x3 ?由于
是通过最小二乘法求出的近似值,所以

是一个近似表达式。
最后对函数表达式
及

进行离散,并将二者做差以便还原
原序列,得到近似数据序列

如下:
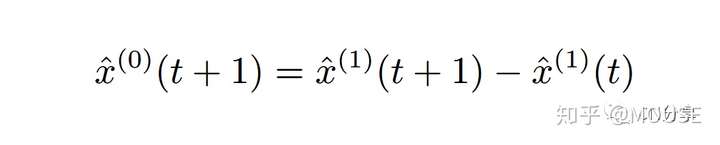 (4)模型检验
计算
与

之间的残差

和相对误差

:
+ E2 f$ t4 T8 }4 X/ D- j& z
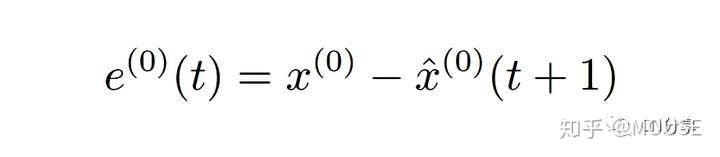 " e2 ?$ q' h; U* C/ X6 F
求原始数据
的均值以及方差

。
求
的平均值

以及残差的方差

。
计算方差

求小误差概率
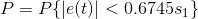
- _; b& L' ]; A) S' ?5 U灰色模型精度检验如下表
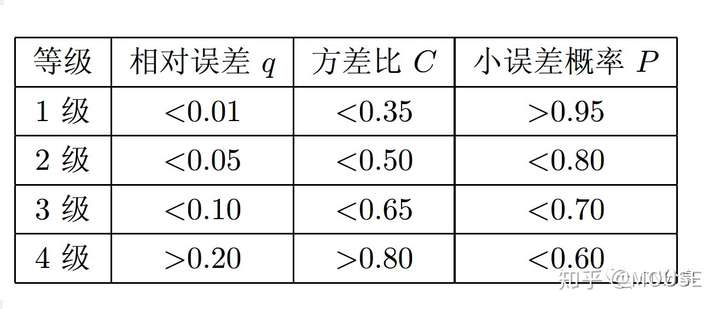
0 G- f6 J) ?$ b- Z" S5 z需要注意的是在实际应用过程中,检验模型的精度的方法并不唯一。可以利用上述方法进行模型的检验,也可以根据

的误差百分比并结合预测数据与实际数据之间的测试结果来确定
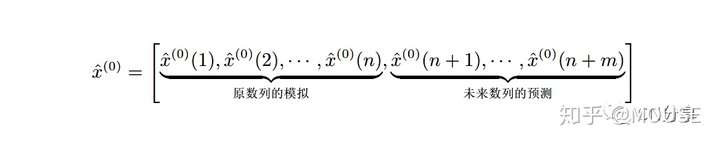
" ^1 Y' H" e' U! X2 L# P(5)确定参数利用模型进行预测:2 E, q: }) j5 D: p' ^5 L
 实际应用
下面通过例子来介绍如何使用GM(1,1)模型。
! U: F* Y4 z7 d( @7 B已知一公司1999-2008年的利润为(单位:元/年)
[89677,99215,109655,120333,135823,159878,182321,209407,246619,300670]
5 \ t' j, I6 T- M/ E,请预测该公司未来几年的利润。
code:
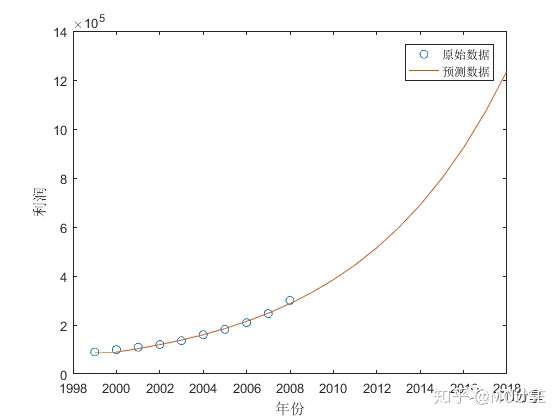
clearsyms a b;c=[a b]';A=[89677,99215,109655,120333,135823,159878,182321,209407,246619,300670];B=cumsum(A); % 原始数据累加n=length(A);for i=1 n-1) C(i)=(B(i)+B(i+1))/2; % 生成累加矩阵end% 计算待定参数的值D=A;D(1)=[];D=D';E=[-C;ones(1,n-1)];c=inv(E*E')*E*D;c=c';a=c(1);b=c(2);% 预测后续数据F=[];F(1)=A(1);for i=2n+10) F(i)=(A(1)-b/a)/exp(a*(i-1))+b/a ;endG=[];G(1)=A(1);for i=2n+10) G(i)=F(i)-F(i-1); %得到预测出来的数据end t1=1999:2008;t2=1999:2018;Gplot(t1,A,'o',t2,G) %原始数据与预测数据的比较legend('原始数据','预测数据');xlabel('年份')ylabel('利润')
* q/ h7 x% O3 a3 L2 ~0 k# M' d效果:% V9 u5 y9 Q' L% s
2 ]0 J+ n. p: J O; `. s" i( k/ F( z1 p如果用GM(1,1)来拟合数据会怎样?
我们的想法是用一个确定的函数值来生成数据,并让其预测接下来的,然后两者比较一下看看效果。
我们采用的函数是
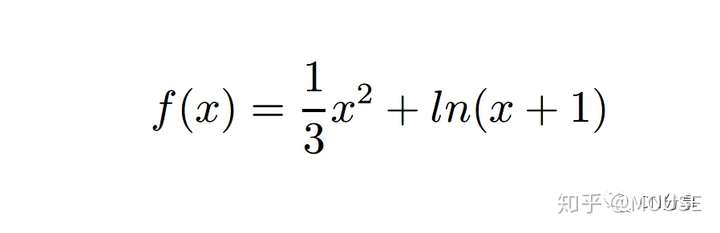 7 V+ q e& Y. Q- c$ ~5 C1 N
code:
! \9 ^/ V. k. R( F; ?' j- U
clearsyms a b;c=[a b]';x = 1:0.5:10;A= 1/3*x.^2 + log(x+1);B=cumsum(A); % 原始数据累加n=length(A);for i=1n-1) C(i)=(B(i)+B(i+1))/2; % 生成累加矩阵end% 计算待定参数的值D=A;D(1)=[];D=D';E=[-C;ones(1,n-1)];c=inv(E*E')*E*D;c=c';a=c(1);b=c(2);% 预测后续数据F=[];F(1)=A(1);for i=2n+4) F(i)=(A(1)-b/a)/exp(a*(i-1))+b/a ;endG=[];G(1)=A(1);for i=2n+4) G(i)=F(i)-F(i-1); %得到预测出来的数据end t1=1:0.5:10;t2=1:0.5:12;t3 = 1:0.5:12;sss = 1/3*t3.^2 + log(t3+1);Gplot(t1,A,'o',t2,G,t3,sss) %原始数据与预测数据的比较legend('原始数据','预测数据','原始函数');xlabel('年份')ylabel('利润'): E2 n/ l. k5 W0 g
效果:) q: c- }7 Q# A, m
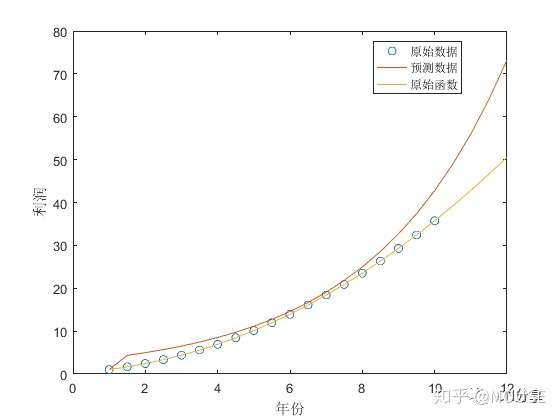
8 Y4 d# k0 v6 U4 \) R随着自变量的增大,两者相差还是蛮大的。
1 @! o+ ~7 `3 ]3 J: {2 m2 ^7 _$ \
2 Z8 W" _! U" c( b; e! }4 [
| 欢迎光临 数学建模社区-数学中国 (http://www.madio.net/) |
Powered by Discuz! X2.5 |